
De mail
In juni kregen we bericht dat het gebouw van ons primaire datacenter dichtging. Worldstream DC1 in Naaldwijk, al meer dan tien jaar de plek van ons hoofdrack, zou later dat jaar leeggehaald en daarna gesloopt worden. Iedere klant moest verhuizen.
Voor ons stond in dat rack het grootste deel van productie: een Proxmox-cluster van zo'n tien hypervisors, twee storageservers, de routers, de switches, en de publieke IP-range waar de DNS-records van onze klanten naar wijzen.
Een gedwongen verhuizing kan betekenen: nieuwe IP-adressen, maandenlang IP-adressen bij klanten laten aanpassen, en een reeks aangekondigde nachtelijke migraties. Deze eindigde zonder dat klanten er veel van merkten. Een deel daarvan kwam doordat de provider de juiste dingen mogelijk maakte. De rest was wekenlang plannen en voorbereiden, en daarna zes weken avondwerk bij ons.
Zelfde groep, ander gebouw
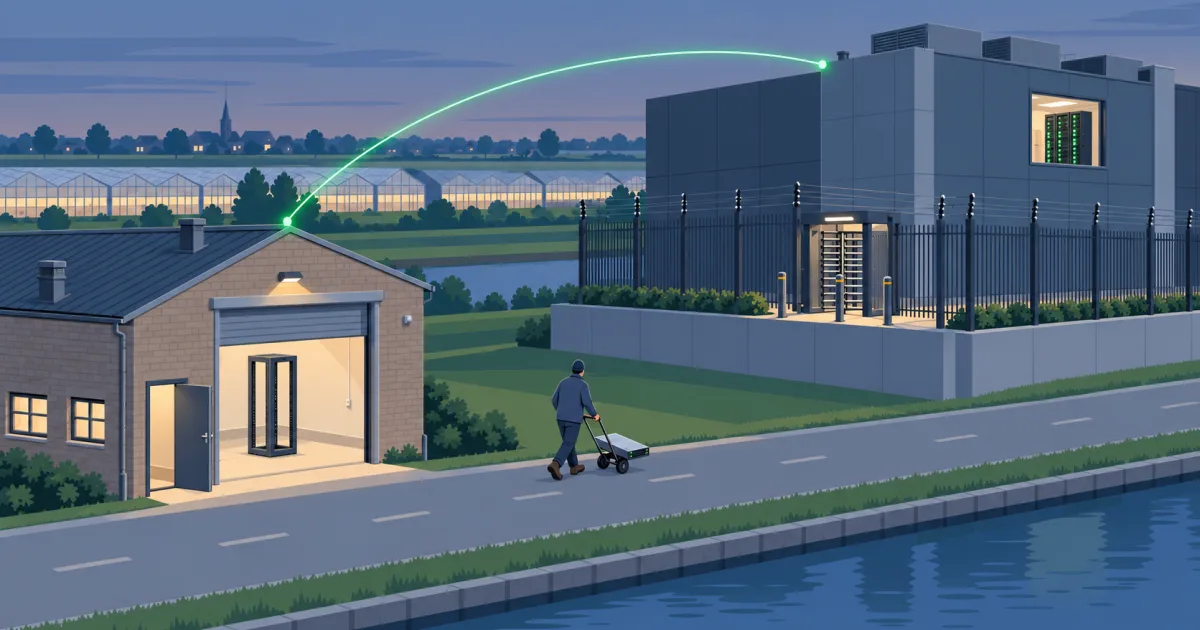
Het antwoord van Worldstream was Greenhouse, een apart datacentermerk binnen dezelfde groep, in een gebouw zo'n 91 meter verderop. De gebouwen zijn gescheiden, maar het netwerk erachter is in beide gevallen dat van Worldstream.
Onze IPv4- en IPv6-ranges bleven daardoor zoals ze waren. Elk DNS-record, elke firewall-allowlist en elke VPN-configuratie bij klanten bleef werken zonder aanpassing. Dat stond vanaf het begin in het contract, en zo is het ook gegaan.
Op het netwerk van Worldstream, de WEN, kan een klant ook zijn eigen VLAN's publiceren. Publiceer dezelfde VLAN's in het oude en het nieuwe rack, en de twee racks delen één netwerk terwijl ze in verschillende gebouwen staan.
Onze verbinding met de inter-datacenter-exchange, die deze locatie met onze andere verbindt, werd door Worldstream in het gebouw zelf omgepatcht. Geen nieuw circuit bestellen, geen derde partij om mee af te stemmen.
Ze haalden ook druk van de planning. Het nieuwe rack was gratis tot oktober, het extra verkeer over hun netwerk tijdens de migratie werd niet gerekend, de oktoberfactuur van het oude rack werd gecrediteerd, en de echte deadline (gebouw op slot op 1 december) lag vroeg op tafel.
Van de begane grond naar anderhalve verdieping hoger
Het oude DC1 was een verbouwd gebouw. De grond eromheen ligt tussen 20 cm onder en 90 cm boven zeeniveau. Ons rack stond op de begane grond, en ons halve rack was de onderste helft ervan. Pasje, gezicht voor de scanner, naar het rack lopen, knielen.
Greenhouse is vanaf het begin als datacenter gebouwd, en dat merk je. De weg naar de zaal is even wennen: een trap op, en dan nog een halve verdieping. Onze hardware staat nu minstens drie meter boven maaiveld, en in Nederland telt dat als overstromingsstrategie.
De beveiliging begint al voor de deur. Buiten staat een tourniquet en een schrikdraad dat overduidelijk onder stroom staat. Dat laatste heb ik op hun woord aangenomen en niet getest. Het gebouw is ook dag en nacht bemand, en dat waardeer ik nog het meest.
Het is er ook warmer. De koude gang bij Greenhouse wordt bewust op 26 graden gehouden, in lijn met de regels voor energie-efficiëntie en de aanbevolen ASHRAE-range. In DC1 was dat 20 tot 21. De eerste week gingen onze temperatuuralerts af op servers die prima in orde waren. We hebben de drempels aangepast, niet de servers.
Het plan
De hardware moest verhuizen terwijl de workloads, voor zover klanten konden zien, bleven waar ze waren.
Proxmox kan een draaiende virtuele machine live van de ene host naar de andere migreren, geheugen en schijf inbegrepen, met een pauze van milliseconden. Daarvoor moeten beide hosts op hetzelfde netwerk zitten, en de WEN gaf ons één netwerk over de twee gebouwen.
Het plan:
- Eerst het nieuwe rack bouwen, met eigen switches en een router, en onze interne netwerken ernaartoe doortrekken.
- Nieuwe hosts in het nieuwe rack zetten, aan het bestaande cluster toevoegen, en er VM's live naartoe migreren.
- Een paar oude hosts leegmaken, uitzetten, in de auto, inbouwen bij Greenhouse, en terug in het cluster.
- Herhalen tot het oude rack leeg is.
Er was de hele tijd één Proxmox-cluster, dat zes weken lang toevallig in twee gebouwen stond.
Het meeste werk gebeurde voordat er iets verhuisde. De rackindeling en het stroombudget lagen in juli klaar. De nieuwe switches werden thuis op een werkbank gebouwd en getest voordat ze in de buurt van een datacenter kwamen. Voor elke grote avond lag er een uitgeschreven runbook met afbreekcriteria, en de gevoeligste klant-VM's verhuisden alleen in tijdvakken die we met de klant hadden afgesproken.
Opleverdag
Het nieuwe rack werd op 18 augustus opgeleverd. 's Ochtends gingen de nieuwe switches en twee nieuwe servers erin, en de uplinks naar het netwerk van Worldstream kwamen in één keer op. Onze publieke IP-range was in het nieuwe rack zichtbaar voordat we iets hadden geconfigureerd: de adressen van de oude router en de gateway van Worldstream waren er meteen.
Die avond mailde ik Worldstream de lijst met VLAN's om te publiceren, en dat is de hele procedure. We zetten ze een voor een aan, eerst één als test. Een hypervisor in het oude gebouw antwoordde vanuit het nieuwe in 0,24 ms, via het netwerk van een provider.
Daarna kwamen de twee nieuwe servers in het cluster, dat nu tien nodes in twee gebouwen had. Om 21:08 migreerde de eerste productie-VM live naar de overkant, in minder dan drie minuten.
De cijfers
De eerste publieke VM hebben we gemeten met externe pings elke 200 ms en een HTTP-probe die de hele tijd liep. De migratie duurde bijna zes minuten, het meeste daarvan was het kopiëren van een schijf van 150 GB. Klanten zouden een onderbreking van ongeveer drie seconden hebben gezien: één mislukte HTTP-probe. De responstijden erna waren gelijk aan die ervoor.
Daar gingen we daarna per VM van uit, en bij de meeste bleef het bij tientallen milliseconden. Een PostgreSQL-productiedatabase van 500 GB verhuisde live zonder enige downtime, na 26 minuten spiegelen.
Kubernetes-nodes gingen een voor een: drainen, uitzetten, verhuizen, opstarten, en pas als het cluster weer volledig gezond was de volgende node. Elke node was een tot drie minuten weg, terwijl de clusters zelf bleven draaien.
Elke fysieke verhuizing begon pas als de nachtelijke backup klaar was. Elke machine ging dus de auto in met een verse backup achter zich.
De servers verhuizen
Toen er eenmaal productie op het nieuwe rack draaide, gingen de oude hosts over in groepjes van twee of drie per rit, eind augustus en in september.
Een Proxmox-cluster accepteert alleen wijzigingen zolang een meerderheid van de nodes elkaar kan zien. Valt de verbinding tussen de gebouwen weg terwijl de nodes gelijk verdeeld zijn, dan heeft geen van beide kanten een meerderheid en accepteren ze allebei geen wijzigingen meer. Draaiende VM's blijven draaien, maar beheren gaat niet meer. We planden elke rit zo dat het cluster nooit op een gelijke verdeling stond. De rekensom is simpel, en makkelijk fout te doen om 21:00 met een server onder je arm.
Toen we de database van een klant eerder naar het nieuwe gebouw verhuisden dan de applicatieservers, ging er niets kapot. Elke query ging voortaan naar het andere gebouw. Onze monitoring slaat daar niet op aan. De applicatie wordt trager en hangt nu af van de verbinding tussen de gebouwen. We hebben de applicaties dezelfde avond nog verhuisd.
Bij twee hosts zaten de netwerkkabels tussen de twee switches verwisseld. Aan de serverkant zag alles er goed uit. Alleen de switches konden het laten zien, omdat in onze opzet alleen de actieve link verkeer stuurt. We hebben het gerepareerd terwijl het rack nog openstond.
Bij het uittrekken van kabels uit het halflege oude rack trok ik de stroomkabel los van een host die gewoon bleef staan. Zijn tweede voeding nam het over.
De laatste dag
Op 30 september werd het oude rack leeggehaald: de storageservers, de primaire router en de laatste switches.
De router vroeg de meeste zorg, want alles loopt erdoorheen. De backuprouter stond sinds augustus al klaar in het nieuwe rack. Vroeg in de ochtend nam die alle interne routering over, met automatische rollback-timers voor het geval er iets misging. Er ging niets mis. Daarna ging de primaire router uit, mee naar de overkant, het rack in, en kreeg hij de routering weer terug.
Worldstream patchte dezelfde dag onze exchange-verbinding om naar het nieuwe rack. Om 14:00 zaten er in het oude rack alleen nog glasvezeleinden, en ging de oude switchstack voor het eerst sinds maart 2022 uit.
De eindcontrole: negen nodes (onderweg hebben we een paar oudere machines uitgefaseerd), alle guests actief, alle gateways up, verbindingen met onze andere locaties up, en de backups van de volgende ochtend compleet.
Voor klanten betekenden de migratieweken af en toe een onderbreking van een paar seconden op publieke VM's. Op de laatste dag waren twee diensten zonder actieve gebruikers offline terwijl de router in de auto lag, en stonden twee backupjobs stil terwijl de storageservers onderweg waren.
De cross-connect die we niet nodig hadden
We hadden een eigen glasvezel tussen de twee racks gepland voor het interne verkeer van het cluster, zodat dat niet over het gedeelde netwerk hoefde. Die is nooit in gebruik genomen. We hebben hem geparkeerd, omdat het netwerk van Worldstream al het verkeer zonder problemen verwerkte. Elke live migratie en elke byte storagereplicatie ging over het netwerk van Worldstream.
Met dank aan
Worldstream en Greenhouse lieten ons onze adressen houden, onze netwerken tussen de gebouwen doortrekken en onze externe verbindingen zonder papierwerk verhuizen, en ze waren vanaf het begin duidelijk over de echte deadline. Daardoor konden we een gedwongen verhuizing in ons eigen tempo doen.
Tussen onze eigen locaties
Hetzelfde patroon gebruiken we tussen onze eigen datacenters. Onze locaties in Naaldwijk, Amsterdam en Zoetermeer zijn verbonden via een inter-datacenter-exchange, met VLAN's over het netwerk van een provider, zodat een netwerk in het ene gebouw ook in het andere kan bestaan.
Onze hardware staat al bij InterDC in Doetinchem, en die locatie gaat binnenkort live. Die is rechtstreeks verbonden met Amsterdam via het netwerk van een partner, met een VLAN dat over beide locaties loopt, zodat ze één netwerk delen, en bereikt Worldstream en de rest via Amsterdam. Op zo'n 13 meter boven zeeniveau is het ook met afstand ons hoogste datacenter.
Daaronder loopt een versleuteld WireGuard-mesh als terugvalpad. Valt de exchange weg, dan worden we trager, maar niet afgesloten.
De verhuizing naar Greenhouse gebruikte hetzelfde idee tussen twee buurgebouwen: eerst het netwerk, daaroverheen de workloads, en de hardware als laatste.
Benieuwd waar jouw applicaties zouden draaien? Lees meer over onze infrastructuur, of neem contact op.